 Baka Labs
 Мейр Розеншейн
Как сохранить бренд-ассеты и маскота от ИИ одинаковыми во всей кампании?
Перестаньте описывать персонажа словами — прикрепляйте его как изображение. Каждая генерация несёт сам якорный образ плюс одну инструкцию: тот же персонаж, просто в новой позе, так что идентичность живёт в пикселях, а не в тексте. Из этого якоря вы собираете набор утверждённых поз, выбираете по одной на каждый материал и накладываете заголовки поверх через HTML. На маскоте soclever, Lottie, это удержало одного аксолотля неизменным на 48 готовых к загрузке рекламных файлах.:
Большинство основателей воспринимают проблему маскота как проблему написания промпта. Сделай описание достаточно точным, думают они, и модель будет рисовать одного и того же персонажа каждый раз. Неверная рамка. У «персиково-золотого аксолотля с перистыми жабрами-плюмажами» тысяча разных лиц, и на каждом вызове модель выбирает новое. Решение — не более удачная фраза. Решение — вообще отказаться описывать персонажа словами.
Почему один и тот же промпт каждый раз даёт другого персонажа?
Потому что текстовое описание заставляет модель заново придумывать персонажа с нуля при каждой генерации, а каждое такое переизобретение — свежий шанс для собственных умолчаний модели просочиться внутрь. Пропорции смещаются, палитра теплеет или холодает, стилистика уходит в сторону. Вы не запрашиваете одного и того же аксолотля дважды — вы дважды запрашиваете лучшую догадку модели по вашим словам, а её догадки не идентичны. Слова могут закрепить жанр («дружелюбный мультяшный аксолотль»). Они не могут закрепить конкретную личность. Для этого нужна сама эта личность в кадре.
Как закрепить персонажа на месте?
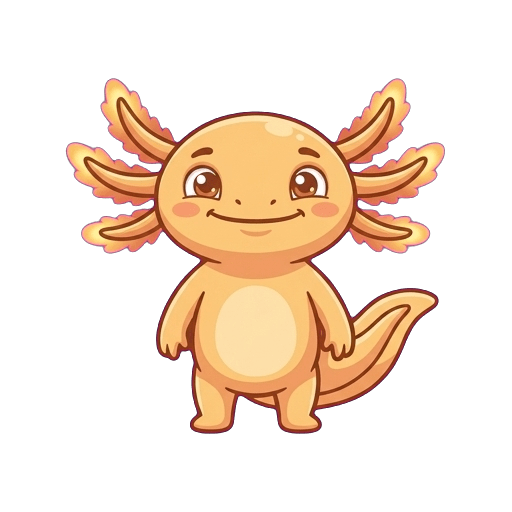
Вы прикрепляете сам якорный образ как часть запроса, перед текстом, и позволяете ему нести идентичность. Тогда промпт говорит только о том, что отличается на этот раз. В soclever внутренний свод правил, управляющий каждой генерацией Lottie, формулирует это как пронумерованный закон:
- Референс-изображение прикрепляется ВСЕГДА. Идентичность живёт в картинке, а не в тексте.
- Внешность НИКОГДА не описывается словами заново. «Text competing with the reference is the #1 cause of drift» — текст, конкурирующий с референсом, это причина дрейфа №1.
- Одно изменение состояния за вызов. Никогда не совмещайте позу, реквизит и смену настроения одновременно.
Единственная несущая инструкция в промпте звучит так: «Keep the mascot's identity (colors, face, proportions) EXACTLY consistent with the attached reference image. It is the same character, just re-posed» — сохрани идентичность маскота (цвета, лицо, пропорции) ТОЧНО такой же, как на прикреплённом референсе; это тот же персонаж, просто в другой позе. Обратите внимание, чего она не делает. Она нигде не повторяет цвета или форму Lottie. Она лишь утверждает, что всё, что есть на прикреплённой картинке, должно остаться, и передаёт модели единственное, чему разрешено меняться, — позу. Изображение ниже сгенерировано ровно так, из якоря выше.
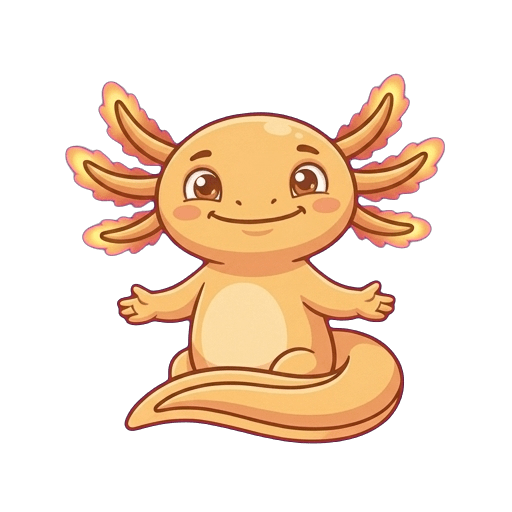
Как получить разнообразие, чтобы оно не уплывало?
Вы собираете набор. Из одного якоря вы генерируете набор утверждённых настроений и образов — коуч, профессор, разведчик, — и каждый из них становится референсом сам по себе, но все они восходят к одной и той же закреплённой идентичности. Затем вы выбираете референс под каждый материал, чтобы заранее задать нужный тон ещё до того, как модель прочтёт хоть слово брифа. В рекламной кампании soclever на шесть курсов сопоставление было редакторским, а не механическим:
"Teach a kid who's given up"   ->  поза коуча       (терпеливый, сидит низко)
"Grow your tutoring business"  ->  собранная поза
"Understand medical results"   ->  ободряющая поза
"Spot fake news"               ->  поза разведчика
"Master Excel"                 ->  поза профессора  (очки, книга)
"Build a portfolio"            ->  обычный якорь 3/4
Это выбранная вариация, а не дрейф. Дрейф — это то, что происходит, когда изображение без референса генерируется из одного текста и умолчания модели вползают внутрь. Выбрать позу коуча вместо позы профессора — осознанное творческое решение среди заранее утверждённых вариантов; персонаж под ним не меняется. Удерживать его на месте помогает набор ограничителей, и каждый ограничитель — это шрам, написанный после реального провала:
- Перья жабр уходили в малиновый. Тёплые сцены тянули золотые перья жабр Lottie в красный, подстраивая под палитру. Решение — постоянное правило, что перья «must stay the mascot's natural warm gold/peach/orange exactly as in the reference image, NEVER crimson, red, or recolored to match the scene palette»: остаются природного тёплого золотисто-персиково-оранжевого точно как на референсе, НИКОГДА не малиновыми, не красными и не перекрашенными под палитру сцены.
- Маскот искажался, когда его нужно было уменьшить. Модель упрощала пропорции вместо масштабирования. Решение: «If the mascot needs to appear smaller in the frame, scale it down; never recolor it» — если маскот должен быть меньше в кадре, уменьшай масштаб, а не перекрашивай.
- В сцену забредал случайный человек. Решение: «NO real human figures, faces, or photographic people anywhere» — никаких настоящих людей, лиц или фотографических персонажей нигде, чтобы аксолотль оставался единственным лицом всего бренда.
Зачем держать любой текст вне арта?
Потому что модели изображений не умеют рисовать читаемый шрифт, а текст, впечатанный в картинку, невозможно перекомпоновать или переписать, не заплатив за целую новую генерацию. Поэтому арт генерируется с тотальным запретом: «ABSOLUTELY NO text, words, letters, numbers, labels, captions, signage, or speech bubbles anywhere in the image» — абсолютно никакого текста, слов, букв, цифр, подписей, надписей, вывесок или речевых пузырей нигде в изображении. Каждый заголовок, чип и логотип-надпись накладываются поверх потом как настоящий HTML-текст, чёткий при любом размере. Это разделение даёт три вещи: идеальный по пикселям шрифт на любом языке, одну исходную иллюстрацию, заново скомпонованную нативно под каждый формат, и свободу переписать заголовок, не перегенерируя ни единого пикселя арта.
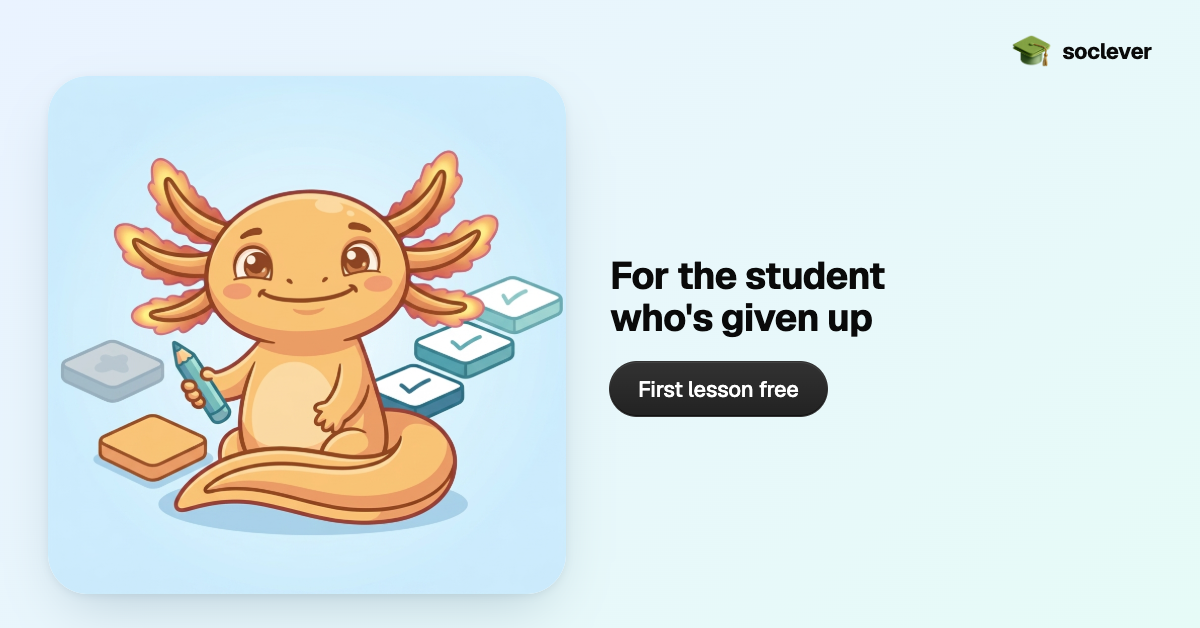
И каждый размер под платформу рендерится нативно, а не обрезается. LinkedIn хочет 1200 на 627, X хочет 1200 на 675, Meta хочет 1200 на 628 — все «горизонталь с колонкой текста», но расходятся на горстку пикселей. Обрежьте один мастер-образ под все три — и маскот или заголовок обрежется на каждом по-своему; вместо этого одна квадратная иллюстрация заново компонуется под семь точных холстов. Приём, который стоит украсть: когда вставляете квадратный арт в неквадратную рамку, зафиксируйте контейнеру жёсткое соотношение сторон, иначе получите белые полосы-леттербоксы сверху и снизу от арта.
Чего это не решает?
Честно сказать, чего он не делает. Обусловливание референсом удерживает неподвижного персонажа стабильным; оно не даёт вам анимацию или оснащённую 3D-модель. Оно также не гарантирует попиксельную идентичность — выражения и ракурсы всё же слегка варьируются, и именно поэтому человек утверждает каждую позу в набор, прежде чем она станет референсом. И работает это только на модели, которая принимает изображение на вход (soclever использует модель изображений Gemini примерно по $0,067 за картинку). То, что вы получаете, — не клон на каждом вызове. Это один и тот же узнаваемый персонаж, каждый раз, примерно за цену ошибки округления. Закрепить персонажа за набором референсов — такая же сборка под один рабочий процесс, как и любой другой проект по внедрению ИИ: узко очертите рамки, запустите и дайте конвейеру окупать себя в каждой следующей кампании.